Puntos de Referencia
Esta página documenta cómo se compara la CLI de Rust actual con la CLI de Python de la versión 7.0.1. Ambas versiones comparten el mismo motor de análisis en Rust; la diferencia es la tubería de la CLI: el análisis de argumentos, la resolución de configuración, el recorrido de rutas y la representación de la salida ahora se ejecutan en Rust, y el intérprete de Python ya no realiza ningún trabajo de análisis. El bloque de entorno más abajo indica la versión y el commit exactos.
Metodología
- CLI nueva: compilada desde el repositorio con
uv run maturin develop --release, invocada como.venv/bin/complexipy. - CLI de referencia:
complexipy==7.0.1instalada desde PyPI conuv adden un proyecto aislado, invocada comobin/complexipyde su entorno virtual. - Paridad de invocación: ambas CLIs se ejecutan como scripts de
consola directos con flags idénticas, cada carga desde su propio
directorio vacío. El envoltorio
uv runqueda excluido de la medición para que ningún lado pague el costo del proceso de uv. - Corpus: repositorios reales de código abierto, clonados de forma superficial en commits fijados, más una prueba de un solo archivo que aísla el arranque del intérprete y de la CLI del análisis del árbol.
- Métricas: tiempo de pared con hyperfine (calentamiento 3, 5
ejecuciones; la prueba de un solo archivo usa calentamiento 5, 20
ejecuciones) con la salida estándar descartada; RSS máximo con
/usr/bin/time -l, 3 ejecuciones, se reporta el máximo. - Puerta de paridad: antes de medir, ambas CLIs exportan JSON para el
repositorio requests y la prueba de un solo archivo. Los códigos de
salida coinciden y cada función que reporta la CLI de referencia tiene
la misma puntuación en la CLI nueva, así que ambos lados puntúan el
mismo código. La CLI nueva también puntúa funciones definidas bajo un
ifo untrya nivel de módulo, que la 7.0.1 omite.
El punto de referencia es repetible:
Environment
- Machine: MacBookPro18,1 (arm64)
- OS: macOS 26.5.1
- CPU: Apple M1 Pro
- RAM: 16 GB
- New CLI: complexipy 8.3.0 (built from 83fbd1d, python 3.12.12)
- Baseline CLI: 7.0.1 (PyPI, python 3.12.12)
- uv: uv 0.10.3 (c75a0c625 2026-02-16)
- hyperfine: hyperfine 1.20.0
- Runs: hyperfine warmup=3 runs=5 (probe warmup=5 runs=20); RSS via /usr/bin/time -l, 3 runs, maximum
- Modes: default, --quiet, --failed, and render (full output written to a file)
- Scaling fixture: 285 base functions, sizes 1x/2x/4x, 5 runs each
- Date: 2026-11-01
Corpus (shallow clones at pinned commits):
- requests @ 5460f467b02e49471c0fd6cfc9ca0adab6351f98 (37 files)
- flask @ d318b683471101618febed18996405ad26462110 (83 files)
- django @ 0b40210e4808937a7c0922e8b7502bff4752faa3 (2929 files)
- single-file probe: requests/src/requests/init.py @ 5460f467b02e49471c0fd6cfc9ca0adab6351f98
Wall time
| Workload | 8.3.0 Rust CLI | 7.0.1 Python CLI | Speedup |
|---|---|---|---|
| requests (37 files) [default] | 0.031 s ± 0.001 s | 0.420 s ± 0.003 s | 13.40x |
| requests (37 files) [quiet] | 0.031 s ± 0.001 s | 0.302 s ± 0.003 s | 9.62x |
| requests (37 files) [failed] | 0.033 s ± 0.001 s | 0.338 s ± 0.004 s | 10.17x |
| requests (37 files) [render] | 0.033 s ± 0.001 s | 0.425 s ± 0.003 s | 12.77x |
| flask (83 files) [default] | 0.033 s ± 0.000 s | 0.479 s ± 0.006 s | 14.70x |
| flask (83 files) [quiet] | 0.034 s ± 0.003 s | 0.318 s ± 0.005 s | 9.33x |
| flask (83 files) [failed] | 0.038 s ± 0.001 s | 0.365 s ± 0.002 s | 9.69x |
| flask (83 files) [render] | 0.034 s ± 0.001 s | 0.480 s ± 0.003 s | 13.96x |
| django (2929 files) [default] | 0.202 s ± 0.002 s | 18.374 s ± 0.087 s | 90.97x |
| django (2929 files) [quiet] | 0.186 s ± 0.002 s | 12.636 s ± 0.061 s | 68.11x |
| django (2929 files) [failed] | 0.195 s ± 0.001 s | 13.928 s ± 0.023 s | 71.60x |
| django (2929 files) [render] | 0.212 s ± 0.009 s | 18.585 s ± 0.061 s | 87.85x |
| single-file probe [default] | 26.5 ms ± 1.5 ms | 87.2 ms ± 3.2 ms | 3.28x |
| single-file probe [quiet] | 25.1 ms ± 1.2 ms | 84.7 ms ± 2.2 ms | 3.38x |
| single-file probe [failed] | 27.4 ms ± 1.0 ms | 87.4 ms ± 2.3 ms | 3.19x |
| single-file probe [render] | 26.3 ms ± 1.1 ms | 88.6 ms ± 1.9 ms | 3.37x |
Scaling (synthetic fixture)
| Size | Mean | Ratio | --quiet mean | Ratio | Peak RSS |
|---|---|---|---|---|---|
| 1x (3995 lines) | 28.9 ms | - | 28.9 ms | - | 26 MB |
| 2x (7990 lines) | 29.5 ms | 1.02 | 31.3 ms | 1.08 | 29 MB |
| 4x (15980 lines) | 36.5 ms | 1.24 | 35.0 ms | 1.12 | 37 MB |
The fixture is generated deterministically by benchmarks/generate_scaling_fixture.py (285 base functions, sizes 1x/2x/4x, kept outside the repo under /Users/rhafid/.cache/complexipy-benchmarks/scaling; never committed). Ratios near 2 mean linear scoring; ratios near 4 mean quadratic behavior.
Peak RSS
| Workload | 8.3.0 Rust CLI | 7.0.1 Python CLI |
|---|---|---|
| requests (37 files) [default] | 35 MB | 39 MB |
| requests (37 files) [quiet] | 34 MB | 38 MB |
| requests (37 files) [failed] | 35 MB | 38 MB |
| requests (37 files) [render] | 34 MB | 39 MB |
| flask (83 files) [default] | 35 MB | 39 MB |
| flask (83 files) [quiet] | 36 MB | 38 MB |
| flask (83 files) [failed] | 35 MB | 38 MB |
| flask (83 files) [render] | 36 MB | 39 MB |
| django (2929 files) [default] | 198 MB | 139 MB |
| django (2929 files) [quiet] | 198 MB | 137 MB |
| django (2929 files) [failed] | 201 MB | 137 MB |
| django (2929 files) [render] | 199 MB | 139 MB |
| single-file probe [default] | 22 MB | 35 MB |
| single-file probe [quiet] | 22 MB | 34 MB |
| single-file probe [failed] | 22 MB | 35 MB |
| single-file probe [render] | 22 MB | 35 MB |
Notes: stdout is discarded during timing except the [render] mode, which writes the full output to a file; both CLIs run as bare console scripts with identical flags. The django workload exits 1 on both CLIs because its own test fixture (tests/test_runner_apps/tagged/tests_syntax_error.py) is intentionally unparseable.
Qué dicen los números
- Los árboles grandes ganan más. django (~2.900 archivos, con su suite de pruebas incluida) es aproximadamente 68-91 veces más rápido: el motor de Rust analiza el árbol en paralelo en todos los núcleos, mientras que la CLI de Python lo procesaba en uno.
- Los árboles pequeños y medianos (requests, flask) son aproximadamente 9-15 veces más rápidos.
- El arranque es más barato. La prueba de un solo archivo es unas 3,3 veces más rápida: es el costo del intérprete de Python y de la importación de typer/rich eliminado del camino crítico.
- La tabla de escalado al final de los resultados mide el motor de Rust con una fixture sintética en tamaños 1x, 2x y 4x. Razones cercanas a 2 significan análisis lineal; razones cercanas a 4 significan comportamiento cuadrático. Las razones registradas rondan 1,0-1,2.
- La representación de la salida también es más barata. Mostrar la tabla completa de resultados en django cuesta ~0,02 s en la CLI de Rust frente a ~5,7 s en la CLI de Python (la diferencia entre el modo por defecto y --quiet), así que la brecha de tiempo crece en árboles grandes cuando los resultados se imprimen de verdad - las filas [render] miden ese camino de extremo a extremo.
- La memoria máxima es menor en árboles pequeños y mayor en los grandes. La CLI de Rust usa 3-5 MB menos en requests y flask y unos 13 MB menos en la prueba de un solo archivo, porque el intérprete de Python y sus bibliotecas de presentación ya no están en el proceso. En django alcanza unos 60 MB más: analiza los archivos en paralelo y reserva memoria con mimalloc, que cambian memoria por velocidad.
Comparación con otras herramientas de complejidad cognitiva
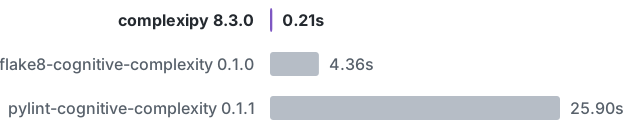
Esta comparación mide las herramientas de Python que calculan la misma métrica, la complejidad cognitiva, sobre el árbol completo de django. Las herramientas que calculan la complejidad ciclomática, como radon o la regla C901 de Ruff, miden otra métrica y no se incluyen.
- flake8-cognitive-complexity se ejecuta como plugin de flake8 con solo
CCR001seleccionada. - pylint-cognitive-complexity se ejecuta como plugin de pylint con todas las demás comprobaciones desactivadas. pylint usa un solo núcleo por defecto.
- Cada herramienta usa un umbral de 15, se ejecuta con su paralelismo por defecto e ignora cualquier configuración del proyecto. Todas las implementaciones siguen el mismo artículo, pero no reportan la misma puntuación para cada función.
- Machine: MacBookPro18,1, Apple M1 Pro
- django @ 0b40210e4808937a7c0922e8b7502bff4752faa3
- complexipy 8.3.0 built from d170454; flake8==7.5.0 flake8-cognitive-complexity==0.1.0; pylint==4.1.3 pylint-cognitive-complexity==0.1.1
- hyperfine warmup=1 runs=5, threshold 15 for every tool, each tool with its default parallelism
- Date: 2026-11-01
| Tool | Mean | Relative to complexipy |
|---|---|---|
| complexipy 8.3.0 | 0.206 s ± 0.004 s | 1.0x |
| flake8-cognitive-complexity 0.1.0 | 4.364 s ± 0.075 s | 21.2x |
| pylint-cognitive-complexity 0.1.1 | 25.896 s ± 1.074 s | 125.7x |